
随着 DeepSeek-V4.1-Flash 陆续在各大云平台上架,在和腾讯对接折扣的时候提到了很有意思的点。有的厂商看似折扣给的低,但是实际上其实是虚的。本着听说不如实测和对比,于是对 DeepSeek 官方、腾讯云 TokenHub(国内机房 & 新加坡节点)以及阿里云百炼(北京) 四个主要入口进行了单路并发实测,重点对比首字响应(TTFT)、解码生成速度、思考模式表现以及前缀缓存(Prompt Caching)的真实命中情况。
寻求一份 https://opencode.ai/ 的 deepseek v4.1的测试加入对比
一、价格与计费对比:百炼缓存单价高达官方 5 倍,峰谷规则天差地别
在深入实测数据前,我们先通过官方公布的定价表对比各平台的调用成本。这里的“官方”均指 DeepSeek 官方定价。
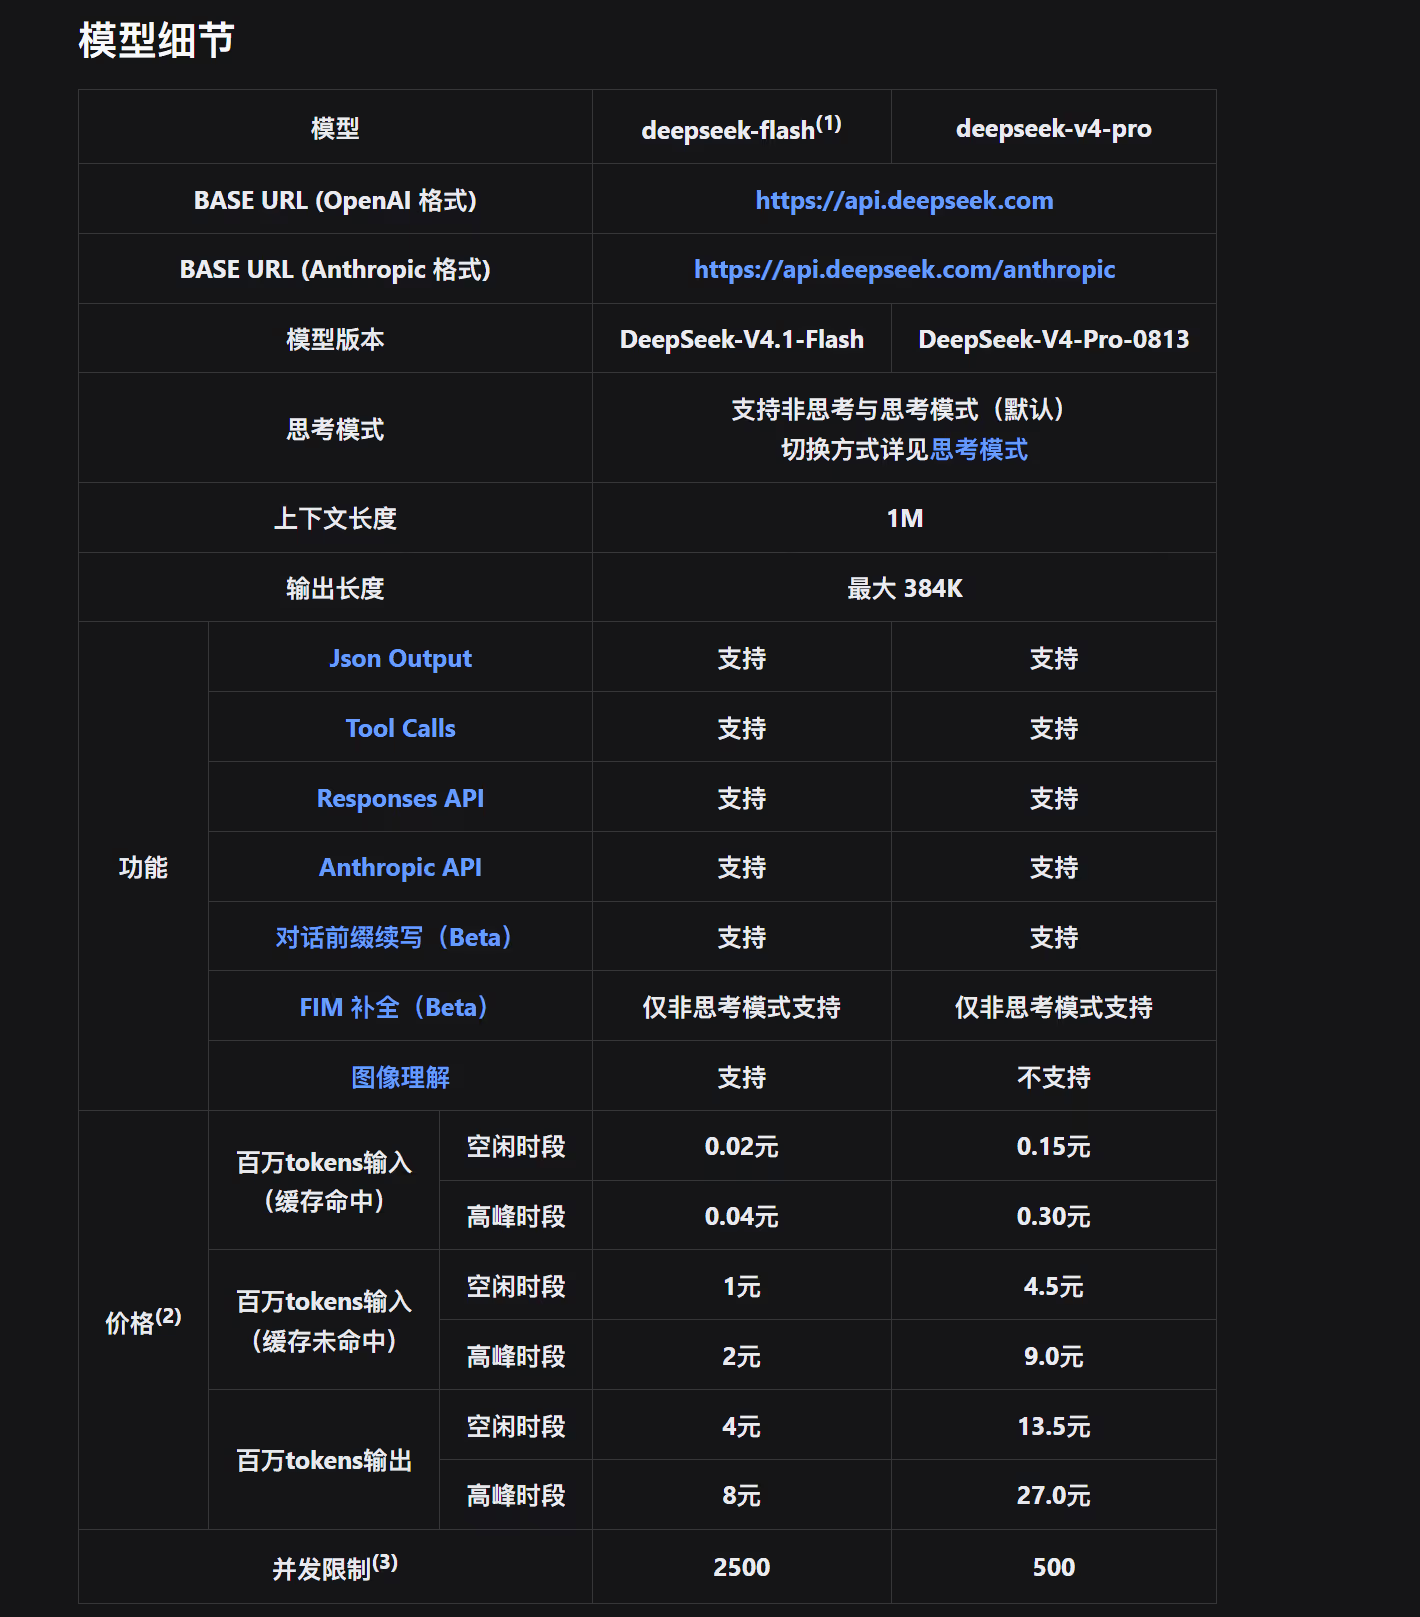
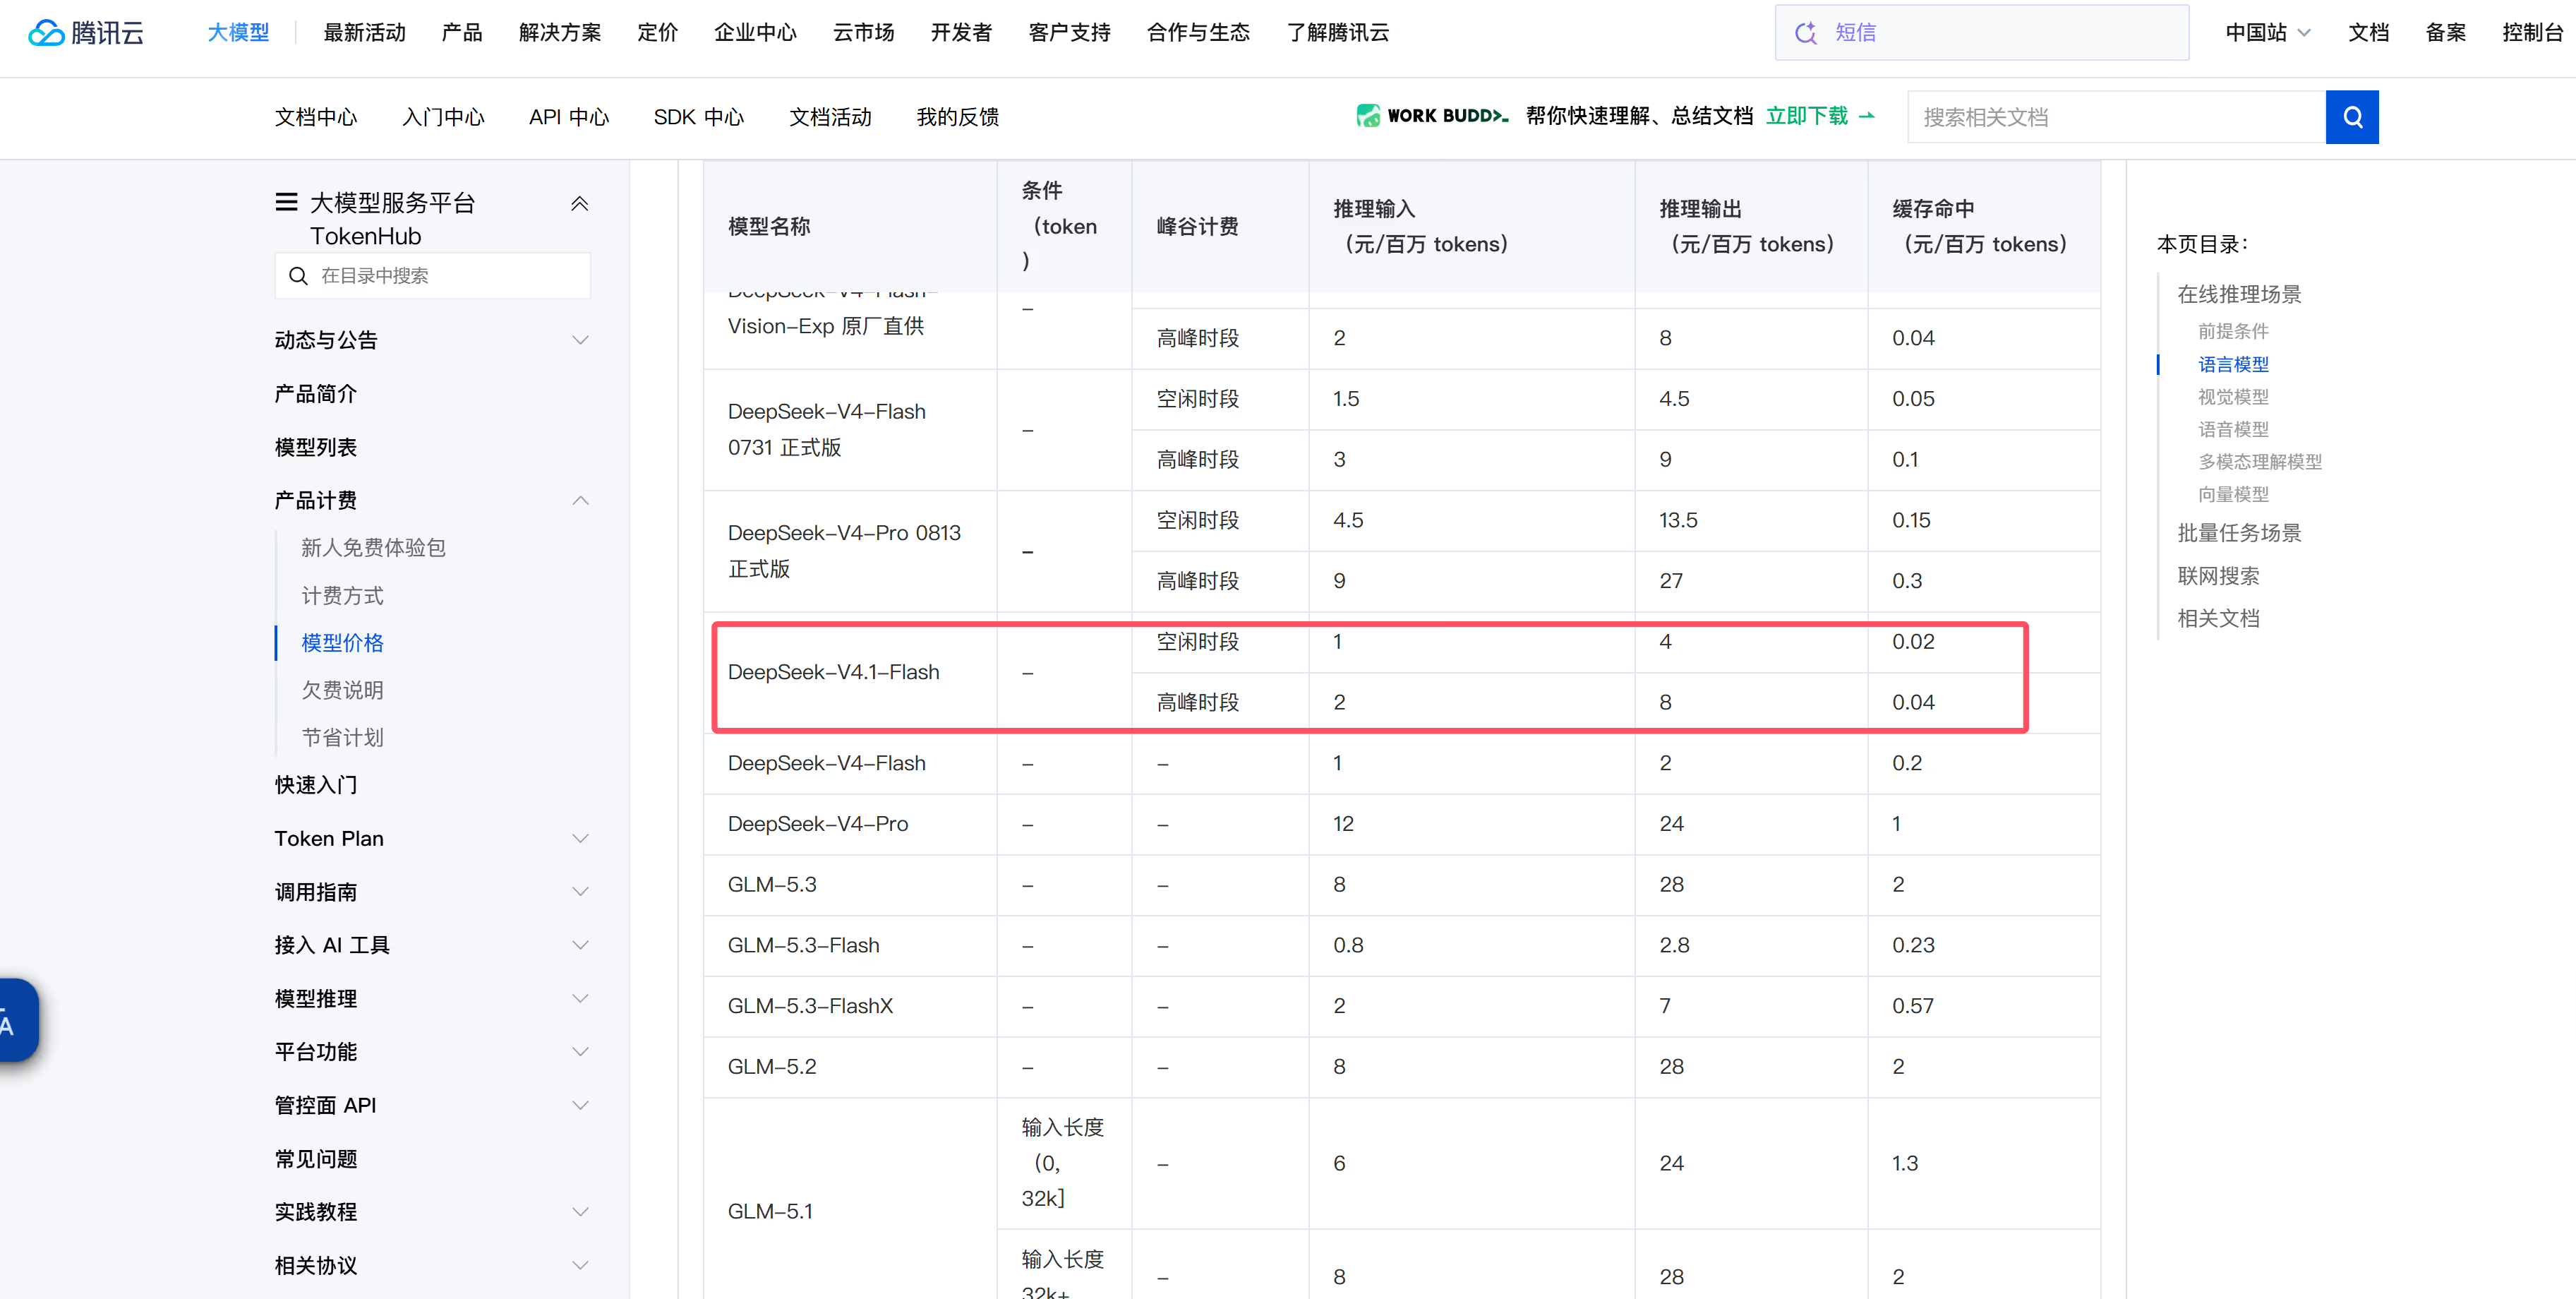
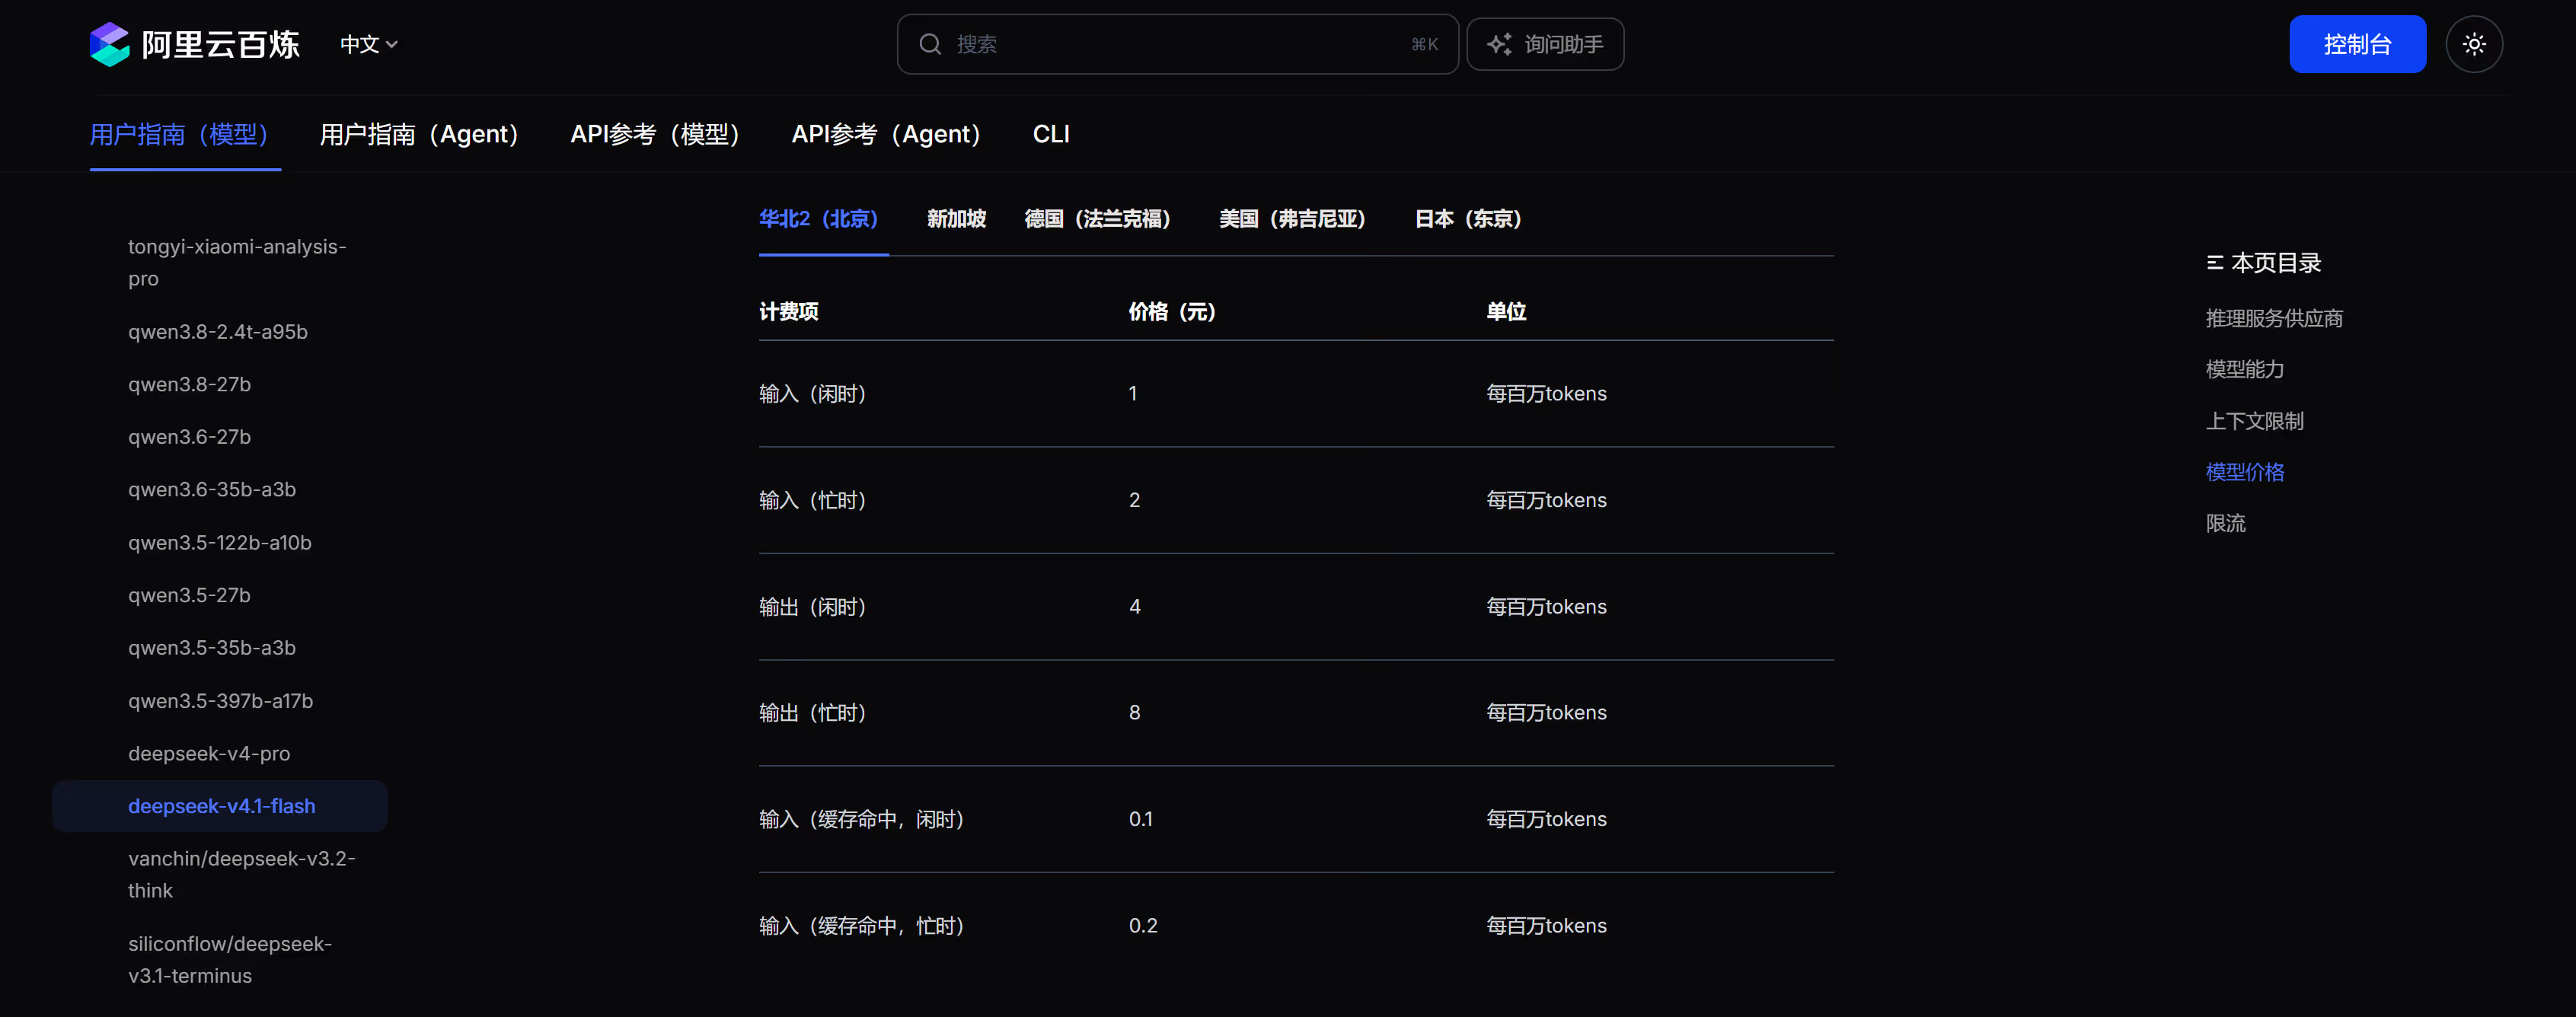
1. 价格横向对比表(单位:元 / 百万 Tokens)
从上面三家平台的官方定价截图可以看到,腾讯云 TokenHub 完全遵照 DeepSeek 官方定价,而阿里云百炼在常规输入与输出上与官方持平,但在缓存命中价格上出现了巨大的剪刀差:
| 计费项目 | 时段 | 阿里百炼 | DeepSeek 官方 / 腾讯 TokenHub | 百炼对比官方 |
|---|---|---|---|---|
| 缓存命中 (Cache Hit) | 闲时 | ¥0.10 | ¥0.02 | 百炼是官方 5 倍 |
| 缓存命中 (Cache Hit) | 忙时 | ¥0.20 | ¥0.04 | 百炼是官方 5 倍 |
| 输入未命中 (Cache Miss) | 闲时 | ¥1.00 | ¥1.00 | 相同 |
| 输入未命中 (Cache Miss) | 忙时 | ¥2.00 | ¥2.00 | 相同 |
| 输出 (Output) | 闲时 | ¥4.00 | ¥4.00 | 相同 |
| 输出 (Output) | 忙时 | ¥8.00 | ¥8.00 | 相同 |
- 百炼缓存溢价高达 5 倍:DeepSeek 官方与腾讯云的缓存命中价仅为 ¥0.02 / ¥0.04,而阿里云百炼高达 ¥0.10 / ¥0.20。也就是说,单看缓存命中成本,官方比百炼直接便宜 80%。
**由此可见某些中转上的百炼分组看似折扣便宜,实际上一点没省。
**
2. 峰谷计费时间段对比
除了单价,两边的峰谷计费时段定义也存在巨大差异:
| 规则维度 | 阿里云百炼 | DeepSeek 官方 | 实际影响分析 |
|---|---|---|---|
| 忙时(高峰期) | 08:00 – 22:00(每天长达 14 小时) | 工作日 09:00–12:00、14:00–18:00(每天仅 7 小时) | 官方忙时仅占百炼的一半时长 |
| 闲时(低谷期) | 22:00 – 次日 08:00(每天仅 10 小时) | 工作日其余 17 小时 + 周六、周日全天 48 小时 | 官方闲时覆盖绝大部分时段 |
| 周末计费规则 | 周末照常按忙时计费(08:00-22:00 算忙时) | 周六、周日全天 100% 享受闲时优惠 | 节假日与周末成本差异极其明显 |
- 百炼闲时窗口严重缩水:百炼每天有 14 个小时算忙时,连周末也不例外,只有深夜至清晨的 10 个小时能享受到闲时单价。
由此可见某些中转上的百炼分组看似折扣便宜,实际上结合峰谷时间和缓存定价的差距,实际上和官方差异巨大。
二、测试环境与接入入口
本次测试从美国节点出口发起单并发请求:
| 渠道 | Base URL | 模型 ID | 支持协议 | 上下文规格 |
|---|---|---|---|---|
| DeepSeek 官方 | https://api.deepseek.com |
deepseek-flash |
Chat / Responses | 上下文 1M,最大输出 384K |
| 腾讯云国内 | https://tokenhub.tencentmaas.com/v1 |
deepseek-v4.1-flash |
Chat / Responses | 腾讯云 TokenHub 国内主入口 |
| 腾讯云新加坡 | https://tokenhub-intl.tencentmaas.com/v1 |
deepseek-v4.1-flash |
Chat / Responses | 腾讯云 TokenHub 国际节点 |
| 阿里云百炼北京 | https://...cn-beijing.maas.aliyuncs.com/compatible-mode/v1 |
deepseek-v4.1-flash |
Chat / Responses | 阿里云百炼兼容接口 |
测试分为两组典型负载:
- 短提示极小输出(测试首字延迟 TTFT):发送极简指令,输出 1 个字,记录建连、TLS 握手及首字回包耗时。
- 长文本生成(测试正文解码速度):要求模型连续输出中文段落,设置上限 256 tokens,精确测算正文字符的吐字速率(tok/s)。
三、关闭思考模式:四渠道实测速度对比
DeepSeek-V4.1-Flash 默认开启思考。关闭思考后,模型直接流式输出正文回答,实测性能如下:
| 渠道 | 首 Token 延迟 (TTFT) | 解码输出速度 (tok/s) | 单路等效吞吐 (tok/min) | 实测表现总结 |
|---|---|---|---|---|
| DeepSeek 官方 | 约 0.80 秒 | 161 ~ 166 tok/s | 约 9,800 tok/min | 响应延迟全场最低,解码稳定在 160+,体验最佳 |
| 腾讯云新加坡 | 约 1.50 秒 | 171 ~ 220 tok/s(均值 191) | 约 11,500 tok/min | 解码速度全场第一,海外出口 TLS 仅 100ms,吞吐极高 |
| 腾讯云国内 | 约 1.97 ~ 2.15 秒 | 121 ~ 136 tok/s | 约 7,600 tok/min | 受跨洋 TLS 握手(~0.5s)影响,国内直连延迟会显著缩短 |
| 阿里云百炼北京 | 约 1.16 ~ 2.40 秒 | 95 ~ 115 tok/s | 约 5,700 tok/min | 握手延迟波动较大,解码速度相对偏慢 |
速度分析要点:
- 吐字速度天花板:腾讯新加坡节点表现亮眼,单路解码均值达到 191 tok/s,峰值甚至跑出 220.4 tok/s,是四家中纯生成吞吐最快的渠道。
- 首字延迟差异:DeepSeek 官方的首字延迟优势最明显(稳在 0.8 秒左右)。腾讯国内节点由于测试机位于美国,跨洋 TLS 握手吃掉了约 500ms,但服务端的首字等待同样平稳。
- 接口一致性:同一家服务商下,走标准 OpenAI 的
/chat/completions和走/responses接口的解码速度完全一致,没有接口级别的性能损耗。
四、开启思考模式:推理阶段与回答阶段分段实测
在开启思考模式(reasoning_effort: high)时,模型会先输出思考推理链(reasoning_tokens),随后再输出正文字符。针对官方和腾讯国内节点的分段测试数据如下:
| 渠道 | 推理首 Token | 推理生成速度 | 正文开始时间 | 正文回答速度 |
|---|---|---|---|---|
| DeepSeek 官方 | 0.94 ~ 1.07 秒 | 247 ~ 273 tok/s | 约 10 ~ 12 秒 | 338 ~ 369 tok/s |
| 腾讯云国内 | 1.94 ~ 2.47 秒 | 199 ~ 204 tok/s | 约 12 ~ 17 秒 | 244 ~ 266 tok/s |
思考模式关键避坑:
- Token 预算共用:官方和腾讯云的
max_tokens(或max_output_tokens)是由推理 token 和正文 token 共享的。如果将max_tokens设得太小(如小于 1024),模型光是思考就会耗尽所有预算,导致正文输出直接被截断或变为空白。使用思考模式时,建议将max_tokens至少设为 2048 至 4096。
五、前缀缓存(Prompt Caching)机制与实测对比
长上下文对话和代码助手中,缓存命中对响应延迟和账单成本起决定性作用。在 4000+ tokens 的相同前缀下测试了各家渠道的缓存复用表现:
| 对比维度 | DeepSeek 官方 | 腾讯云 TokenHub | 阿里云百炼 |
|---|---|---|---|
| 缓存块对齐 | 128 tokens | 128 tokens | 128 tokens |
| 触发门槛 | 自动触发(前缀 > 128 tokens) | 自动触发(前缀 > 128 tokens) | 隐式缓存需 > 1024 相同前缀 tokens |
| Chat 与 Responses 互通性 | 完全互通共用 | 完全互通共用 | 完全隔离,互不相通 |
| Token 计算精确度 | 精确 | 精确 | Responses 接口会多计约 27 个 token |
核心差异与避坑点:
- Chat 与 Responses 跨接口互通:官方与腾讯云做得非常优秀,Chat 接口第一次调用写下的前缀缓存,下一次改用 Responses 接口可以直接热命中,反之亦然。而阿里云百炼在两个接口之间缓存完全隔离,无法交叉复用。
- 百炼门槛与溢价:百炼的隐式缓存起步门槛高达 1024 tokens,且命中单价是官方的 5 倍,再加上接口间不互通,在混合调用场景下的缓存价值大打折扣。
六、开发接入:如何正确关闭思考模式
DeepSeek-V4.1-Flash 默认会开启深度思考。如果你的业务属于普通交互、高并发对话或对 TTFT 极其敏感,建议在请求参数中显式关闭思考模式:
| 渠道 | Chat 接口 (/chat/completions) |
Responses 接口 (/responses) |
|---|---|---|
| DeepSeek 官方 | "thinking": {"type": "disabled"} |
"reasoning": {"effort": "none"} |
| 腾讯云 TokenHub | "thinking": {"type": "disabled"} |
"reasoning": {"effort": "none"} |
| 阿里云百炼 | "enable_thinking": false |
"reasoning": {"effort": "none"} |
注意事项:
- 官方 Responses 接口如果传入
reasoning.effort="no_think"会直接返回 HTTP 422 报错;- 腾讯 Responses 接口传入
no_think仍会产生推理 token;- 两家关闭思考时,Responses 接口请统一传入
"reasoning": {"effort": "none"}。
BOSS catcat 🤚😭✋
BOSS catcat 🤚😭✋
百炼是上次官方涨价他跟着涨,官方降价,他就装死了。