

| LV0 | LV1 | LV2 | LV3 | LV4 | LV5 | LV6 | Total |
|---|---|---|---|---|---|---|---|
| 4831 | 9102 | 2948 | 1738 | 955 | 443 | 208 | 20225 |
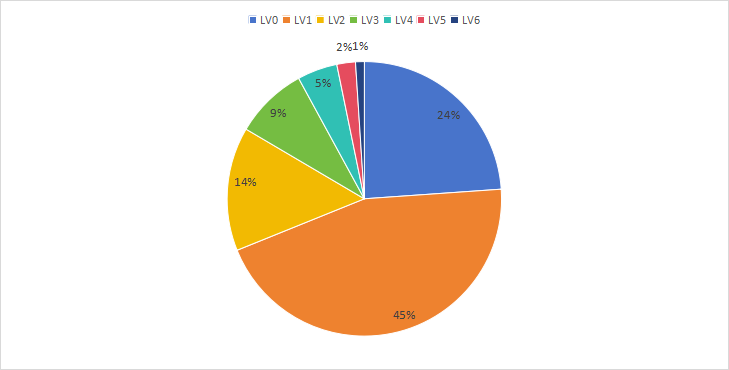
发现了一个小bug:按照最大用户序号来计算用户总数是不合理的,因为有一些不存在的账号例如uid3 @酒神
顺便附上gpt写的代码
import logging
import undetected_chromedriver as uc
from apscheduler.schedulers.background import BackgroundScheduler
from bs4 import BeautifulSoup
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
import time

# 设置 apscheduler 日志级别
logging.getLogger('apscheduler').setLevel(logging.ERROR)

# 初始化浏览器
options = uc.ChromeOptions()
options.headless = False  # 设置为无头模式或窗口模式
driver = uc.Chrome(options=options)

# 定义一个全局变量来存储统计数据
number_counts = {str(i): 0 for i in range(7)}  # 0-6的初始统计值
user_count = 0  # 计数用户ID
lv_counts = {str(i): 0 for i in range(7)}  # 0-6 的初始统计值

def check_content(seq_num):
    """访问指定序号的页面,并检查特定元素的内容。"""
    url = f"https://www.nodeseek.com/space/{seq_num}#/general"
    driver.get(url)

    try:
        # 等待目标元素加载完成
        WebDriverWait(driver, 15).until(
            EC.presence_of_element_located((By.CSS_SELECTOR, "body"))
        )

        # 尝试查找等级元素
        value_element_locator = (By.CSS_SELECTOR, "#nsk-frame > div > div.selector > div.card-block > div:nth-child(2) > div.value")
        value_element = WebDriverWait(driver, 10).until(
            EC.visibility_of_element_located(value_element_locator)
        )

        # 获取页面内容
        soup = BeautifulSoup(driver.page_source, 'html.parser')

        # 查找特定元素内容
        value_element = soup.select_one("#nsk-frame > div > div.selector > div.card-block > div:nth-child(2) > div.value")

        if value_element:
            value = value_element.text.strip()
            if value in number_counts:
                number_counts[value] += 1
                lv_counts[value] += 1
                print(f"用户ID: {seq_num}, 等级: {value}")  # 输出用户ID和等级
            else:
                print(f"用户ID: {seq_num},等级不在统计范围内")
        else:
            # 如果没有找到等级,输出用户不存在
            print(f"用户ID: {seq_num},用户不存在")

    except Exception:
        # 如果任何异常,输出用户不存在
        print(f"用户ID: {seq_num},用户不存在")

def scheduled_job():
    """定义调度任务,按序号递增探测页面内容。"""
    global seq_number, user_count

    check_content(seq_number)
    user_count += 1
    seq_number += 1  # 序号递增

    # 每100个用户输出一次统计
    if user_count % 100 == 0:
        print(f"\n统计到 {user_count} 用户,LV统计数据: {lv_counts}\n")

# 设置初始序号
seq_number = 1
# 创建调度器,允许最多2个并发任务
scheduler = BackgroundScheduler()
scheduler.add_job(scheduled_job, 'interval', seconds=3, max_instances=1)  # 每5秒爬取一个页面,允许最多2个并发
scheduler.start()

try:
    # 主程序持续运行
    while True:
        time.sleep(1)
except (KeyboardInterrupt, SystemExit):
    # 捕捉退出信号,输出最终统计并停止调度器
    print(f"\n程序退出,总共统计到 {user_count} 用户,最终LV统计数据: {lv_counts}\n")
    scheduler.shutdown()
    driver.quit()
侧面证明了其他坛友的想法,升lv2的鸡腿量是升lv1的4倍,要求有点高
矮油 这个1这么多
我还以为6级遍地跑原来才这么点
@丿啦灬啦啦 #2
6级大佬
hh 1%
原来六级才这么点
我一级我骄傲,我是论坛的顶梁柱
@Testcharon #4 毕竟2w里有好多都是0和1级
我好歹也是最早几个满级的,现在鸡腿都超满级需求几倍了,也不知道啥时候开放新等级