@duckNet #26 发布于2025/3/14 17:19:44 @jsllxx #22 发布于2025/3/14 16:21:12 @duckNet #10 发布于2025/3/14 14:47:40 @giyuniba #9 发布于2025/3/14 14:43:24 iptables不更简洁吗,搞这么复杂 iptables已经是很老的技术了,后面肯定全是 nftables的。 复杂是因为lala非对称路由导致的,要论端口转发nftables更简单。 halo家也要设置路由 是不是也是得同样这么设置 我没有 Halo 的,具体你看和 Lala 情况是否相同。 NIC=$(ip -6 addr | grep -B1 'scope global' | awk -F': ' '/^[0-9]+:/{print $2}' | head -n 1) && [ -n "$NIC" ] && ip -6 addr change $(ip -6 addr show dev $NIC | grep 'scope global' | grep -v fd00 | grep -v fe80 | awk '{print $2}') dev $NIC preferred_lft 0 || { echo "未检测到带有全局 IPv6 地址的网络接口,请检查您的网络配置。"; exit 1; }
补充一下 lala这个非对称路由其实没有说详细。 linux路由选择如果有已经存在的socket(可以理解为tcp连接),源ip是根据socket创建的地址的,在lala下面是 192.168.x.x 的地址,但是从lala返回到用户的数据包的地址是一个公网地址 这里用 1.2.3.4 来代替,如果最终地址是1.2.3.4,那么就会匹配默认路由表最终走eth1出去(10.x.x.x的网卡),导致了非对称路由。这就是为什么lala的专线需要配置路由表才能用。 按道理应该走eth0出去的,但是根据路由表匹配,走了eth1出去。 然后我文章中提到的,就是让回来的流量强制走eth0,不走eth1出去,走eth0就可以把数据包返回给国内的用户了。
firewalld底层默认使用nftables。这样写是等效的: 要让firewalld转发生效需要三个条件,sysctl.conf中启用forwarding, firewall规则中启用伪装和转发。 sysctl.conf我有洁癖不去修改它,而是写在这里(文件名随便写,目录必须是这里):/etc/sysctl.d/99-forwarding.conf net.ipv4.ip_forward = 1 net.ipv6.conf.all.forwarding = 1 net.ipv6.conf.default.forwarding = 1 sysctl调优是核心,rmem和wmem要根据实际可用内存计算,还要填窗口存活期,balabala一堆,我写一个我自己用的(2G内存): vm.swappiness = 0 fs.file-max = 1024000 net.core.rmem_max = 134217728 net.core.wmem_max = 134217728 net.core.netdev_max_backlog = 250000 net.core.somaxconn = 1024000 net.core.default_qdisc = fq_pie net.ipv4.conf.all.rp_filter = 0 net.ipv4.conf.default.rp_filter = 0 net.ipv4.conf.lo.arp_announce = 2 net.ipv4.conf.all.arp_announce = 2 net.ipv4.conf.default.arp_announce = 2 net.ipv4.ip_forward = 1 net.ipv4.ip_local_port_range = 1024 65535 net.ipv4.neigh.default.gc_stale_time = 120 net.ipv4.tcp_ecn = 0 net.ipv4.tcp_syncookies = 1 net.ipv4.tcp_tw_reuse = 1 net.ipv4.tcp_low_latency = 1 net.ipv4.tcp_fin_timeout = 10 net.ipv4.tcp_window_scaling = 1 net.ipv4.tcp_keepalive_time = 10 net.ipv4.tcp_timestamps = 0 net.ipv4.tcp_sack = 1 net.ipv4.tcp_fack = 1 net.ipv4.tcp_syn_retries = 3 net.ipv4.tcp_synack_retries = 3 net.ipv4.tcp_max_syn_backlog = 16384 net.ipv4.tcp_max_tw_buckets = 8192 net.ipv4.tcp_fastopen = 3 net.ipv4.tcp_mtu_probing = 1 net.ipv4.tcp_rmem = 4096 87380 67108864 net.ipv4.tcp_wmem = 4096 65536 67108864 net.ipv4.tcp_congestion_control = bbr net.ipv6.conf.all.forwarding = 1 net.ipv6.conf.default.forwarding = 1 net.nf_conntrack_max = 25000000 net.netfilter.nf_conntrack_max = 25000000 net.netfilter.nf_conntrack_tcp_timeout_time_wait = 30 net.netfilter.nf_conntrack_tcp_timeout_established = 180 net.netfilter.nf_conntrack_tcp_timeout_close_wait = 30 net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 30 好,正式开始配置规则,这里是日常运维的部分了(--permanent参数是持久化的意思,临时调试可以不用加,不加的话也不要执行覆盖命令firewall-cmd --reload #开启firewalld伪装和转发功能 firewall-cmd --permanent --add-masquerade firewall-cmd --permanent --add-forward #转发规则1(接收11201端口的tcp+udp流量,转发到12.34.56.78地址的65201端口) firewall-cmd --permanent --zone=public --add-forward-port=port=11201:to-port=65201:to-addr=12.34.56.78:proto=tcp firewall-cmd --permanent --zone=public --add-forward-port=port=11201:to-port=65201:to-addr=12.34.56.78:proto=udp #转发规则2(接收11202端口的tcp+udp流量,转发到12.34.56.79地址的65202端口) firewall-cmd --permanent --zone=public --add-forward-port=port=11202:to-port=65201:to-addr=12.34.56.79:proto=tcp firewall-cmd --permanent --zone=public --add-forward-port=port=11202:to-port=65201:to-addr=12.34.56.79:proto=udp # 重载firewalld规则 firewall-cmd --reload 修改的话原始文件在/etc/firewald/zones/public.xml 好了,再列一个我花了几天用gpt调教出来的一段脚本,可用的。别忘了使用前先配置好sysctl的forwarding参数 #!/bin/bash # 定义规则列表 # 如节点1,将流量从21011端口转发至12.34.56.78地址的65011端口,同时生成tcp+udp转发 rules=( "节点1|21011|65011|12.34.56.78" "节点2|21012|65011|12.34.56.88" "节点3|21013|65011|12.34.56.98" "节点4|21014|65011|12.34.56.108" "节点5|21015|65011|12.34.56.118" "节点6|21016|65011|12.34.56.128" "节点7|21017|65011|12.34.56.138" "节点8|21018|65011|12.34.56.148" ) # Step 0: 清空所有 forward-port 规则 echo "Removing all existing forward-port rules..." while IFS= read -r port_rule; do if [[ -n "$port_rule" ]]; then # 去除可能存在的双引号 clean_rule=$(echo "$port_rule" | sed 's/"//g') echo "Removing forward-port rule: $clean_rule" firewall-cmd --permanent --remove-forward-port="$clean_rule" -q fi done < <(firewall-cmd --list-forward-ports) # Step 1: 逐条添加 IPv4 规则 echo "Adding new IPv4 forwarding rules..." for rule in "${rules[@]}"; do IFS='|' read -r name src_port to_port to_addr <<< "$rule" echo "Adding IPv4 forward rule for: $name" firewall-cmd --permanent --add-forward-port="port=$src_port:proto=tcp:toport=$to_port:toaddr=$to_addr" -q firewall-cmd --permanent --add-forward-port="port=$src_port:proto=udp:toport=$to_port:toaddr=$to_addr" -q done # Step 2: 添加 masquerade 规则(如果未添加) echo "Checking masquerade rules..." if ! firewall-cmd --query-masquerade -q; then echo "Adding masquerade rule..." firewall-cmd --permanent --add-masquerade -q fi # Step 3: 重新加载防火墙 echo "Reloading firewall configuration..." firewall-cmd --reload -q # Step 4: 列出所有已配置的 forward-port 规则 echo "Final configured forward-port rules:" firewall-cmd --list-forward-ports

补充一下 lala这个非对称路由其实没有说详细。
linux路由选择如果有已经存在的socket(可以理解为tcp连接),源ip是根据socket创建的地址的,在lala下面是 192.168.x.x 的地址,但是从lala返回到用户的数据包的地址是一个公网地址 这里用 1.2.3.4 来代替,如果最终地址是1.2.3.4,那么就会匹配默认路由表最终走eth1出去(10.x.x.x的网卡),导致了非对称路由。这就是为什么lala的专线需要配置路由表才能用。
按道理应该走eth0出去的,但是根据路由表匹配,走了eth1出去。
然后我文章中提到的,就是让回来的流量强制走eth0,不走eth1出去,走eth0就可以把数据包返回给国内的用户了。
bd
插眼,学习一下
firewalld底层默认使用nftables。这样写是等效的:
要让firewalld转发生效需要三个条件,sysctl.conf中启用forwarding,
firewall规则中启用伪装和转发。
sysctl.conf我有洁癖不去修改它,而是写在这里(文件名随便写,目录必须是这里):/etc/sysctl.d/99-forwarding.conf
sysctl调优是核心,rmem和wmem要根据实际可用内存计算,还要填窗口存活期,balabala一堆,我写一个我自己用的(2G内存):
好,正式开始配置规则,这里是日常运维的部分了(--permanent参数是持久化的意思,临时调试可以不用加,不加的话也不要执行覆盖命令firewall-cmd --reload
修改的话原始文件在/etc/firewald/zones/public.xml
好了,再列一个我花了几天用gpt调教出来的一段脚本,可用的。别忘了使用前先配置好sysctl的forwarding参数
感谢大佬的教程,我说怎么ipt转发不成功
干货
问下大佬nft配置好后下载延迟很大怎么办呀 速度也跑不起来 全程跟着教程走的 路由也配置了
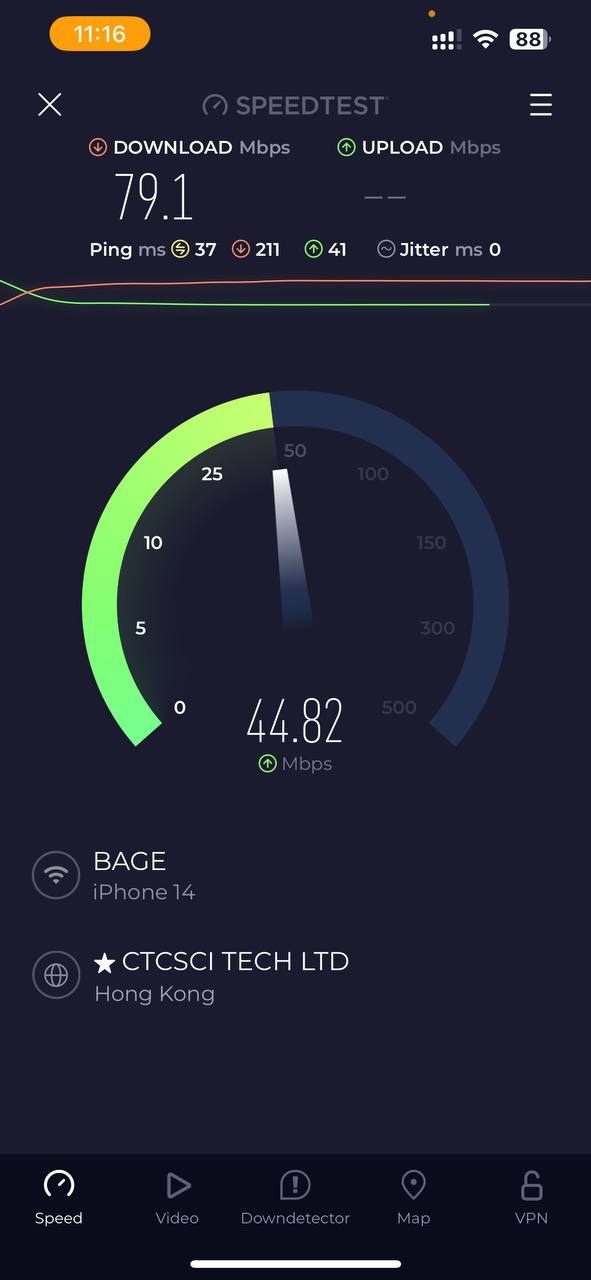
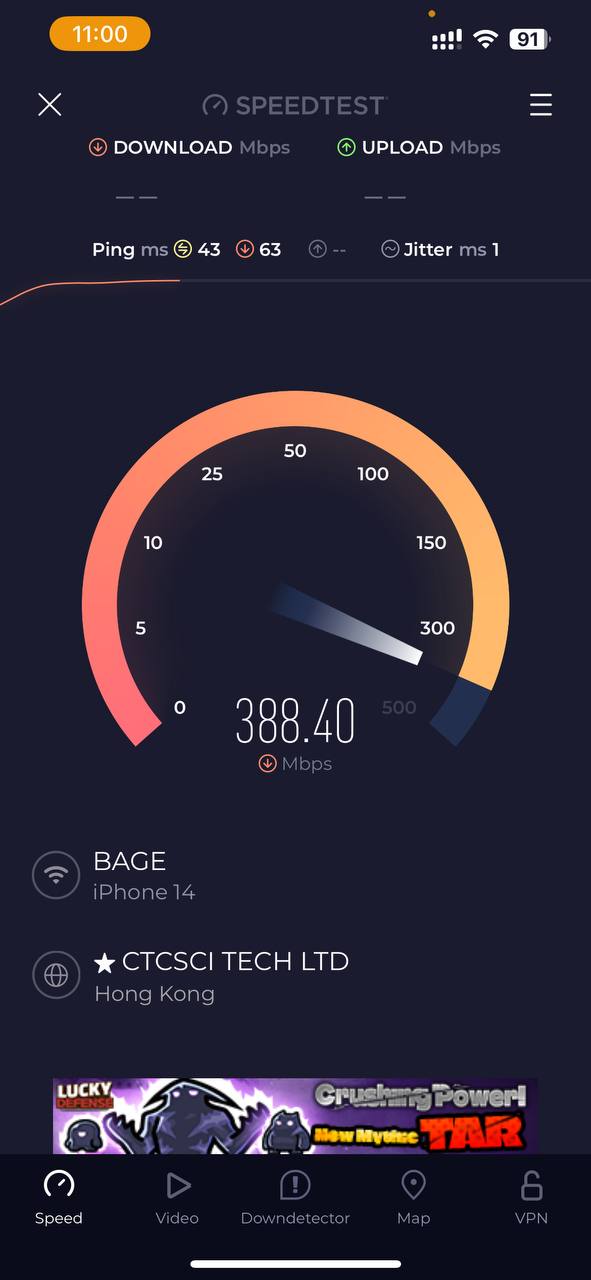
P1是nft p2是我之前用的socat
等一个一键安装带面板的
最后补一下
已经从ipt改用了nft,这个表值得研究,很厉害!